DeepSeek V4.1 di LiteLLM: Proxy, Python SDK, dan Angka Pengeluaran yang Akurat
Tambahkan DeepSeek V4.1 dari API Store ke proxy atau Python SDK LiteLLM dengan satu entri config, dan berikan harganya ke LiteLLM agar log pengeluaran dan anggarannya tepat.
LiteLLM adalah gateway open-source yang menempatkan banyak penyedia model di balik satu API bergaya OpenAI. Tim menjalankannya untuk memberi setiap aplikasi endpoint yang sama, membagikan virtual key, dan menetapkan anggaran per tim. Artikel ini menunjukkan cara menambahkan DeepSeek V4.1 dari API Store ke LiteLLM, lewat proxy atau langsung dari Python, dan cara membuat LiteLLM menghitung biayanya dengan benar.
Mengapa DeepSeek lewat API Store
API Store mengikuti format OpenAI, jadi LiteLLM berbicara dengannya seperti berbicara dengan OpenAI. Anda mendapat DeepSeek V4.1 seharga US$0,21 per juta token input dan US$0,84 per juta token output, lebih murah di luar jam sibuk, dibayar dari saldo prabayar tanpa langganan. API key yang sama juga bisa dipakai untuk model video Seedance dan model gambar Seedream jika nanti Anda membutuhkannya.
Proxy: satu entri di config.yaml
model_list:
  - model_name: deepseek-v4-1-flash
    litellm_params:
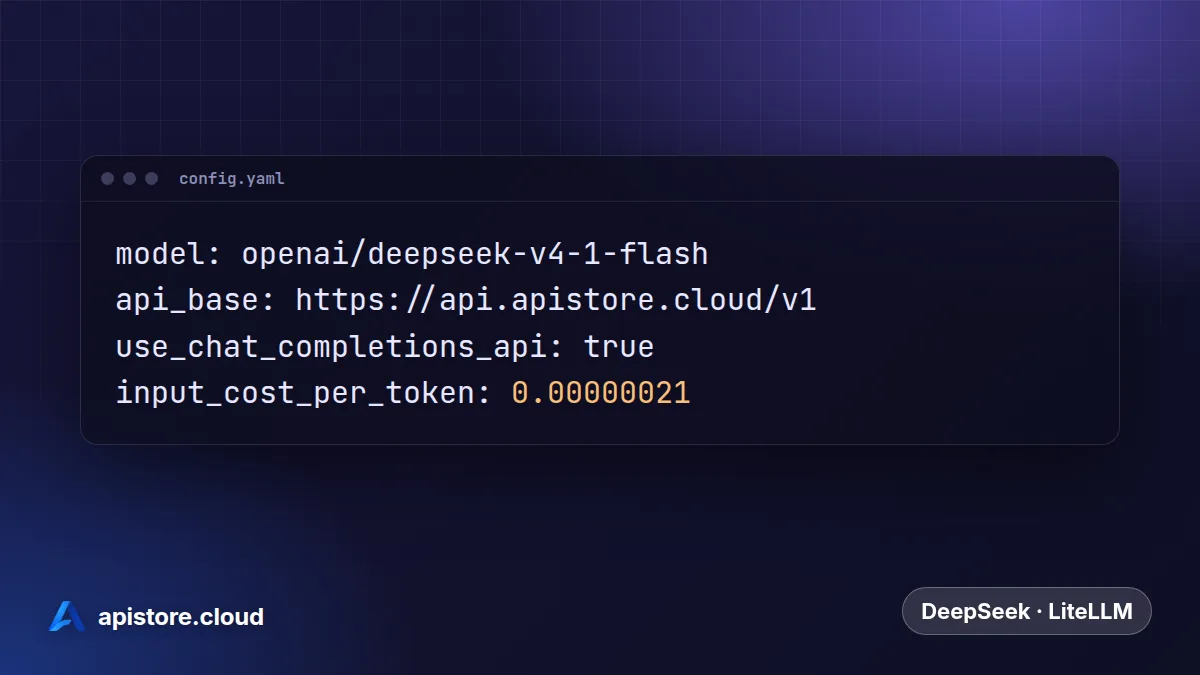
      model: openai/deepseek-v4-1-flash
      api_base: https://api.apistore.cloud/v1
      api_key: os.environ/APISTORE_API_KEY
      use_chat_completions_api: true
      input_cost_per_token: 0.00000021
      output_cost_per_token: 0.00000084
      cache_read_input_token_cost: 0.0000000042
Empat bagian yang melakukan pekerjaannya:
openai/memberi tahu LiteLLM bahwa model ini memakai OpenAI API. Nama di belakangnya adalah nama model di API Store.api_basemengirim request ke API Store, bukan ke OpenAI.use_chat_completions_apimembuat LiteLLM mengirim request Responses API dan Anthropic Messages sebagai chat completions. Penjelasannya ada di bawah.- Baris biaya adalah harga per token. Tanpanya LiteLLM tidak tahu apa-apa tentang model ini dan mencatat setiap request sebesar $0.
Jalankan proxy dengan key Anda di environment, lalu panggil dengan model_name dari config:
export APISTORE_API_KEY=sk-...
litellm --config config.yaml

curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-v4-1-flash", "messages": [{"role": "user", "content": "Say hello"}]}'
Response-nya membawa header x-litellm-response-cost. Untuk "Say hello" yang pendek, nilainya sekitar $0.00001, sama dengan yang ditagih API Store untuk token tersebut dengan harga standar.
Harga di atas adalah harga hari ini. Panduan setup LiteLLM menyusun config yang sama dengan harga terkini sudah terisi.
Python SDK, tanpa proxy
import os
from litellm import completion

response = completion(
    model="openai/deepseek-v4-1-flash",
    api_base="https://api.apistore.cloud/v1",
    api_key=os.environ["APISTORE_API_KEY"],
    messages=[{"role": "user", "content": "Say hello"}],
)
print(response.choices[0].message.content)
Tambahkan stream=True untuk streaming jawaban. Tool call bekerja sama seperti pada model OpenAI: kirim tools, dan response berisi tool_calls dengan nama fungsi dan argumennya. Ada contoh lengkap keduanya di blog ini.
Klien Responses API dan Anthropic Messages
LiteLLM menerjemahkan antarformat API, jadi model di balik proxy juga bisa menjawab di endpoint /v1/responses dan /v1/messages. Tool yang dibuat untuk Responses API atau Anthropic Messages API pun bisa memakai DeepSeek V4.1 tanpa perubahan.
Untuk itulah use_chat_completions_api: true. Model openai/ diperlakukan sebagai OpenAI itu sendiri, jadi tanpa baris ini LiteLLM meneruskan request tersebut ke endpoint Responses OpenAI, dan API Store menjawab 404 Unknown path /v1/responses. Dengan baris ini, LiteLLM mengubahnya menjadi chat completions terlebih dahulu, dan biayanya dihitung dengan cara yang sama.
Dua model, dua entri
deepseek-v4-1-flash-economy berharga US$0,168 per juta token input dan US$0,672 per juta token output. Untuk menyediakan keduanya, salin entrinya, ganti kedua nama model, dan pakai harga economy. Aplikasi lalu memilih model berdasarkan model_name-nya, dan anggaran LiteLLM mencakup keduanya.
Selaraskan dua anggaran
LiteLLM dan API Store masing-masing punya batas pengeluaran, dan fungsinya berbeda:
- Di LiteLLM, beri setiap tim atau aplikasi virtual key dengan anggaran. Itu membagi pengeluaran di dalam perusahaan Anda.
- Di API Store, beri proxy LiteLLM key tersendiri dengan batas pengeluaran harian. Itulah batas keras jika ada yang terjebak dalam loop.
Baris biaya memakai harga jam sibuk. Harga di luar jam sibuk separuhnya, jadi pada jam-jam itu LiteLLM mencatat hingga dua kali lipat dari yang Anda bayar. Halaman Penggunaan di dashboard API Store Anda menampilkan tagihan persis dari setiap request.
Troubleshooting
- 401 invalid_api_key:
APISTORE_API_KEYtidak di-set di tempat proxy berjalan, hanya di shell Anda sendiri. - 404 model_not_found: nama setelah
openai/harus nama model API Store, persis seperti di halaman harga. - Pengeluaran tercatat $0: baris biaya tidak ada di
litellm_params. - 404 Unknown path /v1/responses pada
/v1/responsesatau/v1/messages: tambahkanuse_chat_completions_api: truekelitellm_params. - 402 insufficient_balance: lakukan top-up, atau naikkan batas harian key.
Berapa biayanya
LiteLLM gratis dan tidak menambahkan biaya apa pun. Setiap request ditagih ke saldo API Store Anda dengan harga per token model tersebut: US$0,21 input dan US$0,84 output per juta token untuk deepseek-v4-1-flash, dengan input dari cache seharga US$0,0042. Halaman harga memuat semua model.
Juga di English, Tiếng Việt, Español, Português