DeepSeek V4.1 no LiteLLM: proxy, SDK Python e gasto com números reais
Adicione o DeepSeek V4.1 da API Store ao proxy ou ao SDK Python do LiteLLM com uma única entrada de config, e informe os preços para que os registros de gasto e os orçamentos fiquem corretos.
O LiteLLM é um gateway de código aberto que reúne muitos provedores de modelos atrás de uma API no estilo da OpenAI. As equipes o usam para dar o mesmo endpoint a todos os aplicativos, distribuir chaves virtuais e definir orçamentos por equipe. Este artigo mostra como adicionar o DeepSeek V4.1 da API Store a ele, pelo proxy ou direto do Python, e como fazer o LiteLLM calcular o custo corretamente.
Por que usar o DeepSeek pela API Store
A API Store segue o formato da OpenAI, então o LiteLLM conversa com ela do mesmo jeito que com a OpenAI. Você usa o DeepSeek V4.1 a US$ 0,21 por milhão de tokens de entrada e US$ 0,84 por milhão de tokens de saída, e menos fora do horário de pico, pago de um saldo pré-pago e sem assinatura. A mesma chave também acessa os modelos de vídeo Seedance e de imagem Seedream se você precisar deles depois.
O proxy: uma entrada no config.yaml
model_list:
  - model_name: deepseek-v4-1-flash
    litellm_params:
      model: openai/deepseek-v4-1-flash
      api_base: https://api.apistore.cloud/v1
      api_key: os.environ/APISTORE_API_KEY
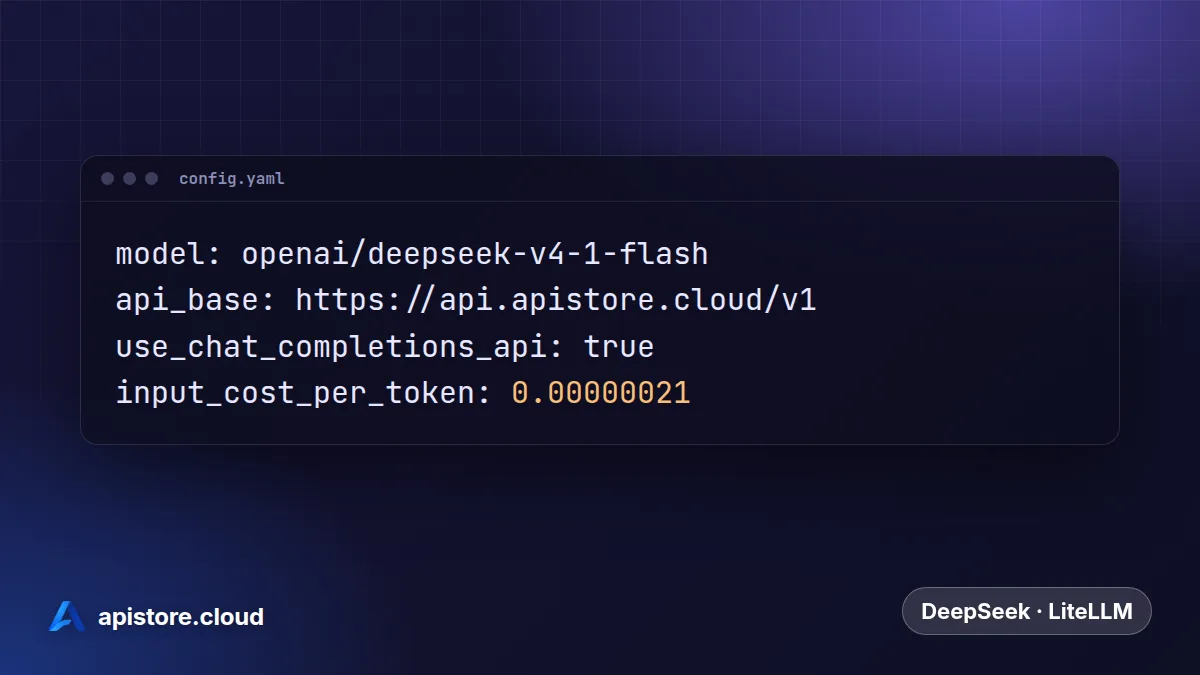
      use_chat_completions_api: true
      input_cost_per_token: 0.00000021
      output_cost_per_token: 0.00000084
      cache_read_input_token_cost: 0.0000000042
Quatro partes fazem o trabalho:
openai/informa ao LiteLLM que o modelo usa a API da OpenAI. O nome que vem depois é o nome do modelo na API Store.api_baseenvia as requisições para a API Store em vez da OpenAI.use_chat_completions_apifaz o LiteLLM enviar as requisições da Responses API e da Anthropic Messages como chat completions. Mais sobre isso abaixo.- As linhas de custo são os preços por token. Sem elas, o LiteLLM não sabe nada sobre o modelo e registra cada requisição como $0.
Inicie o proxy com a sua chave no ambiente e depois chame-o com o model_name da config:
export APISTORE_API_KEY=sk-...
litellm --config config.yaml

curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-v4-1-flash", "messages": [{"role": "user", "content": "Say hello"}]}'
A resposta traz o cabeçalho x-litellm-response-cost. Para um "Say hello" curto ele fica em cerca de $0.00001, que é o que a API Store cobra por esses tokens no preço padrão.
Os preços acima são os de hoje. O guia de configuração do LiteLLM monta a mesma config com os preços atuais.
O SDK Python, sem proxy
import os
from litellm import completion

response = completion(
    model="openai/deepseek-v4-1-flash",
    api_base="https://api.apistore.cloud/v1",
    api_key=os.environ["APISTORE_API_KEY"],
    messages=[{"role": "user", "content": "Say hello"}],
)
print(response.choices[0].message.content)
Adicione stream=True para receber a resposta em streaming. As chamadas de ferramentas funcionam como nos modelos da OpenAI: passe tools e a resposta traz tool_calls com o nome da função e os argumentos. Há um exemplo completo das duas coisas neste blog.
Clientes da Responses API e da Anthropic Messages
O LiteLLM traduz entre formatos de API, então um modelo atrás do proxy também pode responder nos endpoints /v1/responses e /v1/messages. Uma ferramenta feita para a Responses API ou para a Anthropic Messages API pode usar o DeepSeek V4.1 sem mudanças.
É para isso que serve use_chat_completions_api: true. Um modelo openai/ é tratado como a própria OpenAI, então sem essa linha o LiteLLM encaminha essas requisições para um endpoint de Responses da OpenAI, e a API Store responde 404 Unknown path /v1/responses. Com ela, o LiteLLM as converte primeiro em chat completions, e o custo é calculado do mesmo jeito.
Dois modelos, duas entradas
O deepseek-v4-1-flash-economy custa US$ 0,168 por milhão de tokens de entrada e US$ 0,672 por milhão de tokens de saída. Para oferecer os dois, copie a entrada, troque os dois nomes do modelo e use os preços do economy. Os aplicativos escolhem o modelo pelo model_name, e os orçamentos do LiteLLM cobrem os dois.
Mantenha os dois orçamentos alinhados
O LiteLLM e a API Store têm limites de gasto, e cada um cumpre uma função:
- No LiteLLM, dê a cada equipe ou aplicativo uma chave virtual com orçamento. Isso divide o gasto dentro da sua empresa.
- Na API Store, dê ao proxy do LiteLLM uma chave própria com limite de gasto diário. Esse é o teto firme se algo entrar em loop.
As linhas de custo usam o preço do horário de pico. Fora do pico os preços caem pela metade, então nesses horários o LiteLLM pode registrar até o dobro do que você paga. A página Usage do seu painel da API Store tem o valor exato de cada requisição.
Solução de problemas
- 401 invalid_api_key:
APISTORE_API_KEYnão está definida onde o proxy roda, só no seu terminal. - 404 model_not_found: o nome depois de
openai/deve ser um nome de modelo da API Store, exatamente como na página de preços. - O gasto aparece como $0: faltam as linhas de custo em
litellm_params. - 404 Unknown path /v1/responses em
/v1/responsesou/v1/messages: adicioneuse_chat_completions_api: trueaolitellm_params. - 402 insufficient_balance: recarregue o saldo ou aumente o limite diário da chave.
Quanto custa
O LiteLLM é gratuito e não cobra nenhuma taxa própria. Cada requisição é descontada do seu saldo da API Store pelo preço por token do modelo: US$ 0,21 de entrada e US$ 0,84 de saída por milhão de tokens para o deepseek-v4-1-flash, com a entrada em cache a US$ 0,0042. A página de preços tem todos os modelos.
Também em English, Tiếng Việt, Español