DeepSeek V4.1 en LiteLLM: proxy, SDK de Python y gasto con cifras reales
Agrega DeepSeek V4.1 de API Store al proxy o al SDK de Python de LiteLLM con una sola entrada de config, y dale los precios para que sus registros de gasto y presupuestos sean correctos.
LiteLLM es un gateway de código abierto que reúne muchos proveedores de modelos detrás de una API al estilo de OpenAI. Los equipos lo usan para dar a todas sus aplicaciones el mismo endpoint, repartir claves virtuales y fijar presupuestos por equipo. Este artículo muestra cómo agregarle DeepSeek V4.1 de API Store, con el proxy o directamente desde Python, y cómo hacer que LiteLLM calcule bien el costo.
Por qué usar DeepSeek a través de API Store
API Store sigue el formato de OpenAI, así que LiteLLM le habla igual que a OpenAI. Obtienes DeepSeek V4.1 a USD 0.21 por millón de tokens de entrada y USD 0.84 por millón de tokens de salida, y menos fuera de las horas pico, pagado desde un saldo prepago y sin suscripción. La misma clave también llega a los modelos de video Seedance y de imagen Seedream si los necesitas más adelante.
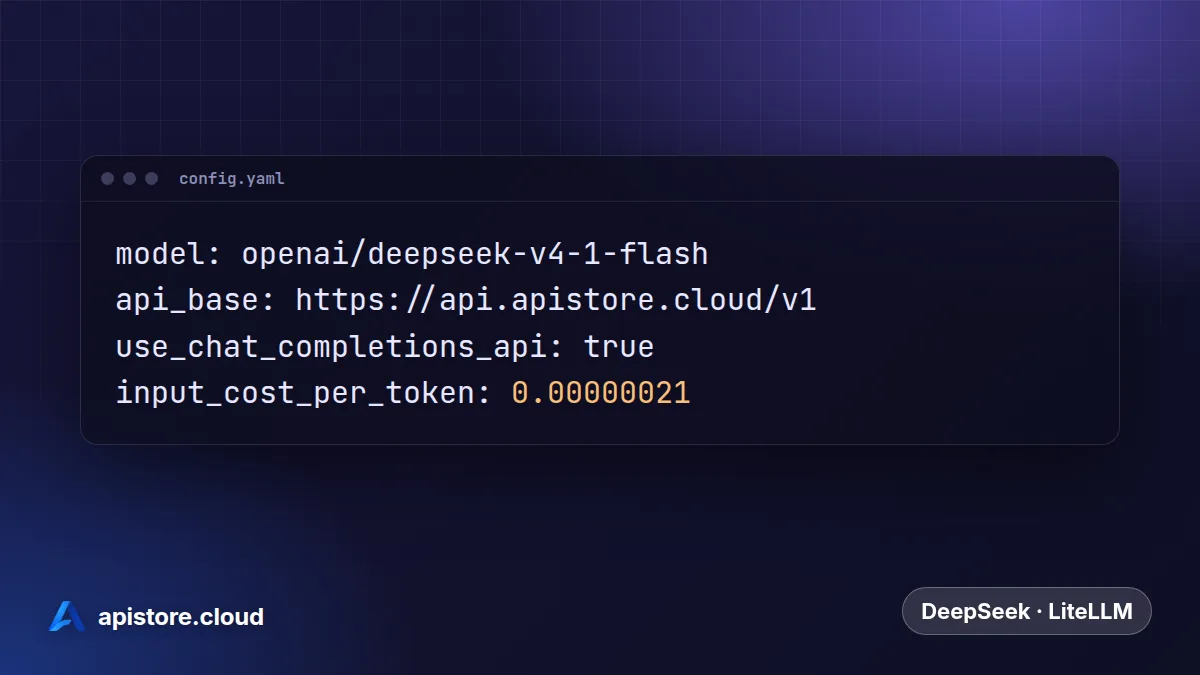
El proxy: una entrada en config.yaml
model_list:
  - model_name: deepseek-v4-1-flash
    litellm_params:
      model: openai/deepseek-v4-1-flash
      api_base: https://api.apistore.cloud/v1
      api_key: os.environ/APISTORE_API_KEY
      use_chat_completions_api: true
      input_cost_per_token: 0.00000021
      output_cost_per_token: 0.00000084
      cache_read_input_token_cost: 0.0000000042
Cuatro partes hacen el trabajo:
openai/le indica a LiteLLM que el modelo usa la API de OpenAI. El nombre que sigue es el nombre del modelo en API Store.api_baseenvía las solicitudes a API Store en lugar de a OpenAI.use_chat_completions_apihace que LiteLLM envíe las solicitudes de la Responses API y de Anthropic Messages como chat completions. Más sobre esto abajo.- Las líneas de costo son los precios por token. Sin ellas, LiteLLM no sabe nada del modelo y registra cada solicitud en $0.
Inicia el proxy con tu clave en el entorno y luego llámalo con el model_name de la config:
export APISTORE_API_KEY=sk-...
litellm --config config.yaml

curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-v4-1-flash", "messages": [{"role": "user", "content": "Say hello"}]}'
La respuesta trae el encabezado x-litellm-response-cost. Para un "Say hello" corto es de unos $0.00001, que es lo que API Store cobra por esos tokens al precio estándar.
Los precios de arriba son los de hoy. La guía de configuración de LiteLLM arma la misma config con los precios actuales.
El SDK de Python, sin proxy
import os
from litellm import completion

response = completion(
    model="openai/deepseek-v4-1-flash",
    api_base="https://api.apistore.cloud/v1",
    api_key=os.environ["APISTORE_API_KEY"],
    messages=[{"role": "user", "content": "Say hello"}],
)
print(response.choices[0].message.content)
Agrega stream=True para recibir la respuesta en streaming. Las llamadas a herramientas funcionan igual que con los modelos de OpenAI: pasa tools y la respuesta trae tool_calls con el nombre de la función y sus argumentos. En este blog hay un ejemplo completo de ambas cosas.
Clientes de la Responses API y de Anthropic Messages
LiteLLM traduce entre formatos de API, así que un modelo detrás del proxy también puede responder en sus endpoints /v1/responses y /v1/messages. Una herramienta hecha para la Responses API o para la Anthropic Messages API puede usar DeepSeek V4.1 sin cambios.
Para eso sirve use_chat_completions_api: true. Un modelo openai/ se trata como si fuera OpenAI, así que sin esa línea LiteLLM reenvía esas solicitudes a un endpoint de Responses de OpenAI, y API Store responde 404 Unknown path /v1/responses. Con ella, LiteLLM las convierte primero en chat completions, y el costo se calcula igual.
Dos modelos, dos entradas
deepseek-v4-1-flash-economy cuesta USD 0.168 por millón de tokens de entrada y USD 0.672 por millón de tokens de salida. Para ofrecer los dos, copia la entrada, cambia los dos nombres del modelo y usa los precios de economy. Las aplicaciones eligen el modelo por su model_name, y los presupuestos de LiteLLM cubren ambos.
Mantén alineados los dos presupuestos
LiteLLM y API Store tienen límites de gasto, y cumplen funciones distintas:
- En LiteLLM, da a cada equipo o aplicación una clave virtual con presupuesto. Así se reparte el gasto dentro de tu empresa.
- En API Store, da al proxy de LiteLLM su propia clave con un límite de gasto diario. Ese es el tope firme si algo entra en un bucle.
Las líneas de costo usan el precio de horas pico. Los precios en horas valle son la mitad, así que en esas horas LiteLLM puede registrar hasta el doble de lo que pagas. La página Usage de tu panel de API Store tiene el cargo exacto de cada solicitud.
Solución de problemas
- 401 invalid_api_key:
APISTORE_API_KEYno está definida donde se ejecuta el proxy, solo en tu terminal. - 404 model_not_found: el nombre después de
openai/debe ser un nombre de modelo de API Store, tal como aparece en la página de precios. - El gasto aparece en $0: faltan las líneas de costo en
litellm_params. - 404 Unknown path /v1/responses en
/v1/responseso/v1/messages: agregause_chat_completions_api: truealitellm_params. - 402 insufficient_balance: recarga saldo o aumenta el límite diario de la clave.
Cuánto cuesta
LiteLLM es gratis y no agrega ninguna tarifa propia. Cada solicitud se descuenta de tu saldo de API Store al precio por token del modelo: USD 0.21 de entrada y USD 0.84 de salida por millón de tokens para deepseek-v4-1-flash, con la entrada en caché a USD 0.0042. La página de precios tiene todos los modelos.
También en English, Tiếng Việt, Português